
Eine Entscheidungsvorlage kann sprachlich abgeschlossen sein, obwohl die entscheidende Frage noch offen ist. Das fällt besonders dort ins Gewicht, wo eine überzeugende Darstellung mit einer belastbaren Begründung verwechselt wird. Ein Sprachmodell kann Alternativen ordnen, Widersprüche benennen und Rechenwege prüfen. Ob die richtige Aufgabe gestellt wurde, welche Nachteile hinnehmbar sind und wer die Folgen trägt, bleibt eine Führungsaufgabe.
Meine Position ist deshalb einfach. KI gehört in den Entscheidungsprozess, und die bewährten Methoden der Problemlösung gehören weiterhin dazu. Wer beides verbindet, benötigt eine Arbeitsweise, die den eigenen Anteil am Urteil sichtbar hält. Genau dafür ist Kupermann Decision Partner angelegt, eine offen zugängliche Arbeitsanleitung für die Zusammenarbeit mit einem Sprachmodell.
Eine ältere Methode für eine neue Arbeitsteilung
George Pólya gliederte das mathematische Problemlösen in seinem erstmals 1945 erschienenen Buch How to Solve It in vier Phasen. Die Aufgabe verstehen, einen Plan entwickeln, den Plan ausführen und auf das Ergebnis zurückblicken. Diese einfache Gliederung macht deutlich, dass die eigentliche Ausführung nur ein Teil der Arbeit ist. Pólya, Princeton University Press
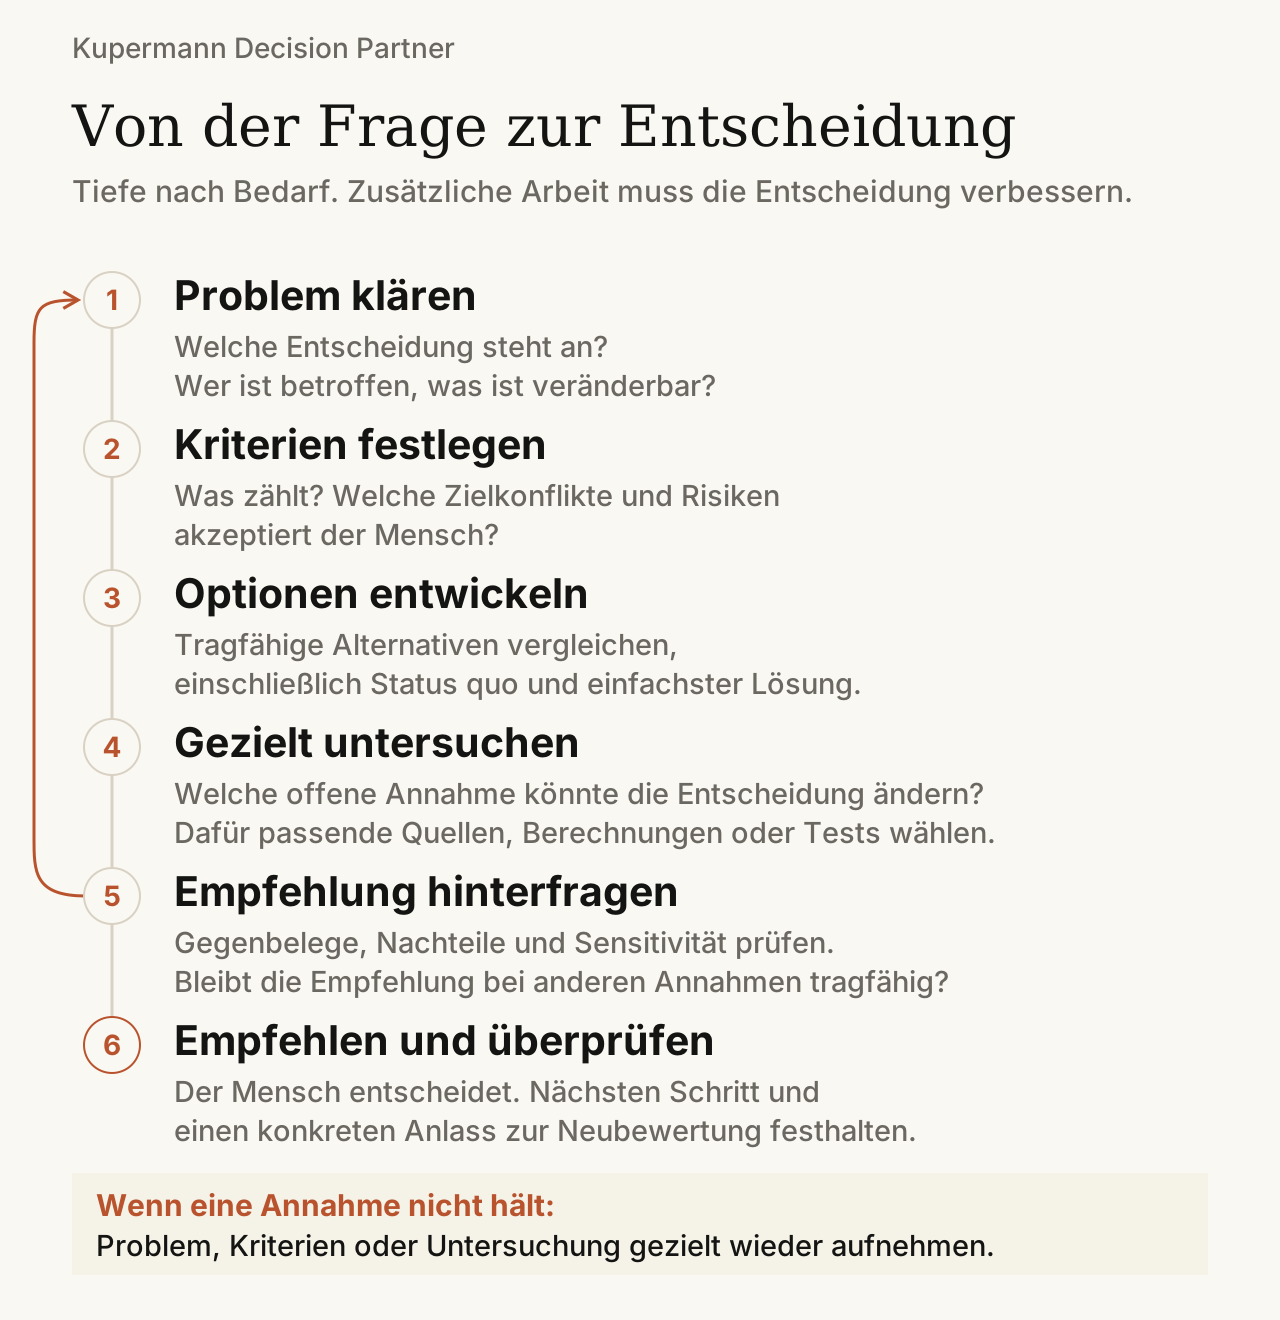
Für die hier vorgeschlagene Arbeitsweise dient diese Gliederung als Ausgangspunkt. Das Repository konkretisiert sie in sechs Schritten, von der Problemklärung über Kriterien, Optionen und gezielte Untersuchung bis zur Gegenprüfung und späteren Überprüfung der Entscheidung. Vor der Analyse stehen die Entscheidung, ihre Grenzen und ein Kriterium für ein brauchbares Ergebnis. Am Ende steht neben dem Beschluss auch die Frage, an welchem späteren Befund sich seine Qualität erkennen lässt. Die Übertragung auf betriebliche Entscheidungen ist eine Gestaltungsentscheidung dieses Projekts, kein von Pólya geprüfter Anwendungsfall.
Im Gespräch mit einem Sprachmodell kommt es auf die Reihenfolge an. Bei einer folgenreichen Entscheidung kann es nützlich sein, zunächst die eigene Einschätzung mitsamt einer wichtigen Annahme und einer offenen Frage festzuhalten. Liegt sie bereits vor, arbeitet das Modell damit. Möchte die verantwortliche Person keine zusätzliche Einschätzung formulieren, wird die Bearbeitung fortgesetzt. Der Zweck ist eine nützliche Gegenprüfung, kein verpflichtender Zwischenschritt. Ein anfängliches Urteil darf sich ändern, aber die Gründe dafür sollen erkennbar bleiben.
Was die Forschung tatsächlich hergibt
Risko und Gilbert beschreiben kognitive Entlastung als Auslagerung geistiger Arbeit an äußere Hilfsmittel. Ihr Übersichtsartikel behandelt Bedingungen und Folgen dieses Vorgangs. Er ist weder ein Experiment mit dem hier vorgestellten Verfahren noch ein Nachweis, dass jede Entlastung das Denken verschlechtert. Risko und Gilbert, 2016
Lee und Kollegen untersuchten Selbstauskünfte von Wissensarbeitern zum Einsatz generativer KI. Höheres Vertrauen in die KI hing mit geringerem berichteten kritischen Denkaufwand zusammen. Die Befragung misst Zusammenhänge und Wahrnehmungen. Sie belegt keine durch KI verursachte Abnahme der geistigen Fähigkeiten. Lee et al., 2025
Buçinca und Kollegen untersuchten Eingriffe, die vor der Übernahme einer KI-Empfehlung eigenes Nachdenken verlangen. Gegenüber Oberflächen mit einfachen Erklärungen verringerten diese die übermäßige Übernahme falscher Empfehlungen, brachten aber keinen signifikanten zusätzlichen Gewinn bei der Gesamtleistung. Die Systeme wurden als komplexer bewertet. Buçinca et al., 2021
Bastani und Kollegen untersuchten unterschiedliche GPT-4-Lernhilfen in einem Feldexperiment im Mathematikunterricht. Die Gestaltung der Hilfe beeinflusste, was bei einer späteren Prüfung ohne KI erhalten blieb. Ein solcher Bildungsbefund lässt sich nicht unmittelbar auf erfahrene Fachkräfte oder Managemententscheidungen übertragen. Bastani et al., 2025
Aus diesen Arbeiten leite ich eine Anforderung an die Gestaltung ab. Unterstützung sollte überprüfbares eigenes Denken ermöglichen. Dazu gehören nachvollziehbare Quellen, sichtbare Annahmen und Gelegenheit zum Widerspruch. Wie viel zusätzliche Arbeit sich dafür lohnt, hängt von der konkreten Entscheidung ab.
Klare Zuständigkeiten
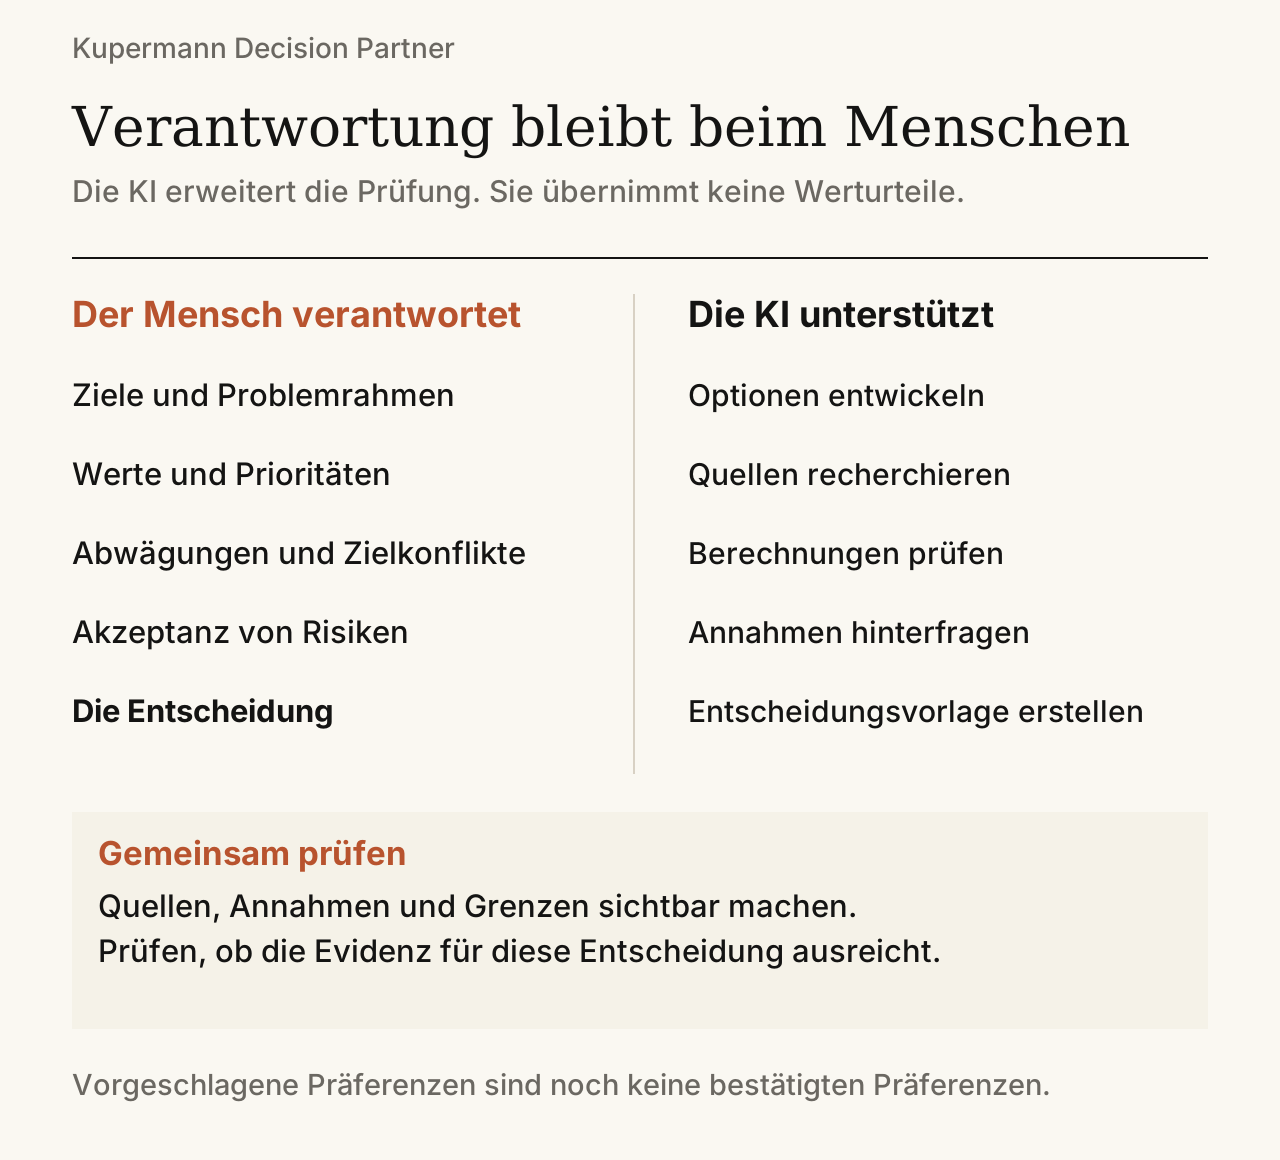
Der Mensch bestimmt Ziel, Randbedingungen und akzeptable Folgen. Er legt fest, welche Informationen vertraulich bleiben, und verantwortet die Entscheidung gegenüber den Betroffenen. Das Modell unterstützt bei der Strukturierung, entwickelt Gegenpositionen und macht fehlende Angaben sichtbar. Seine Aussagen über die Außenwelt brauchen Quellen, seine Rechnungen einen nachvollziehbaren Rechenweg. Eine überzeugende Begründung durch dasselbe Modell ist keine unabhängige Prüfung.
Kupermann Decision Partner hält dafür die Ausgangslage, mögliche Vorgehensweisen, Belege und Einwände in einer gemeinsamen Arbeitsfolge zusammen. Offene Punkte bleiben offen, bis ein Nachweis vorliegt oder die verantwortliche Person ausdrücklich mit der Unsicherheit entscheidet. Die Tiefe der Bearbeitung richtet sich nach Tragweite und Umkehrbarkeit. Eine leicht korrigierbare Alltagsentscheidung benötigt weniger Aufwand als die Einführung eines Systems, dessen Fehler Kunden erreichen.
Ein Pilot und eine vorschnelle Hochrechnung
Ein fiktiver Fall zeigt, worauf es ankommt. Acht erfahrene Beschäftigte erproben freiwillig eine KI-Hilfe an 80 Routineanfragen im Kundenservice. Gemeldet werden sechs Minuten Zeitgewinn je Anfrage. Die Vorlage für eine Einführung im gesamten Bereich rechnet diesen Wert auf das Jahresvolumen hoch. In den sechs Minuten fehlt allerdings die durchschnittlich vierminütige Nachprüfung. Zwei falsche Angaben zu Kündigungsbedingungen werden dabei rechtzeitig entdeckt. Diese Zahlen sind frei gewählte Annahmen eines Lehrbeispiels, keine Projektergebnisse.
Die erste Korrektur betrifft die Rechnung. Von 24.000 Anfragen im Jahr seien 60 Prozent Routinefälle, also 14.400 Vorgänge. Zwei Minuten Nettogewinn je Vorgang ergeben 28.800 Minuten oder 480 Stunden. Bei angenommenen 50 Euro je Stunde entspricht das einem Kapazitätswert von 24.000 Euro. Nach 18.000 Euro jährlicher Lizenzkosten verbleiben rechnerisch 6.000 Euro. Weitere 12.000 Euro für die erstmalige Integration ergeben im ersten Jahr einen Saldo von minus 6.000 Euro.
Auch diese korrigierte Rechnung beweist noch keinen wirtschaftlichen Nutzen. Frei werdende Arbeitszeit ist zunächst Kapazität. Sie wird erst dann zur finanziellen Einsparung, wenn tatsächlich vermeidbare Kosten entfallen. Zudem stammen die Beobachtungen von erfahrenen Freiwilligen und einer kleinen Auswahl von Routinefällen. Für schwierigere Anfragen, andere Beschäftigte oder die Fehlerquote im laufenden Betrieb liefert das Beispiel keinen belastbaren Nachweis. Die beiden entdeckten Fehler belegen den Wert der konkreten Prüfung, aber nicht, dass alle Fehler entdeckt wurden.
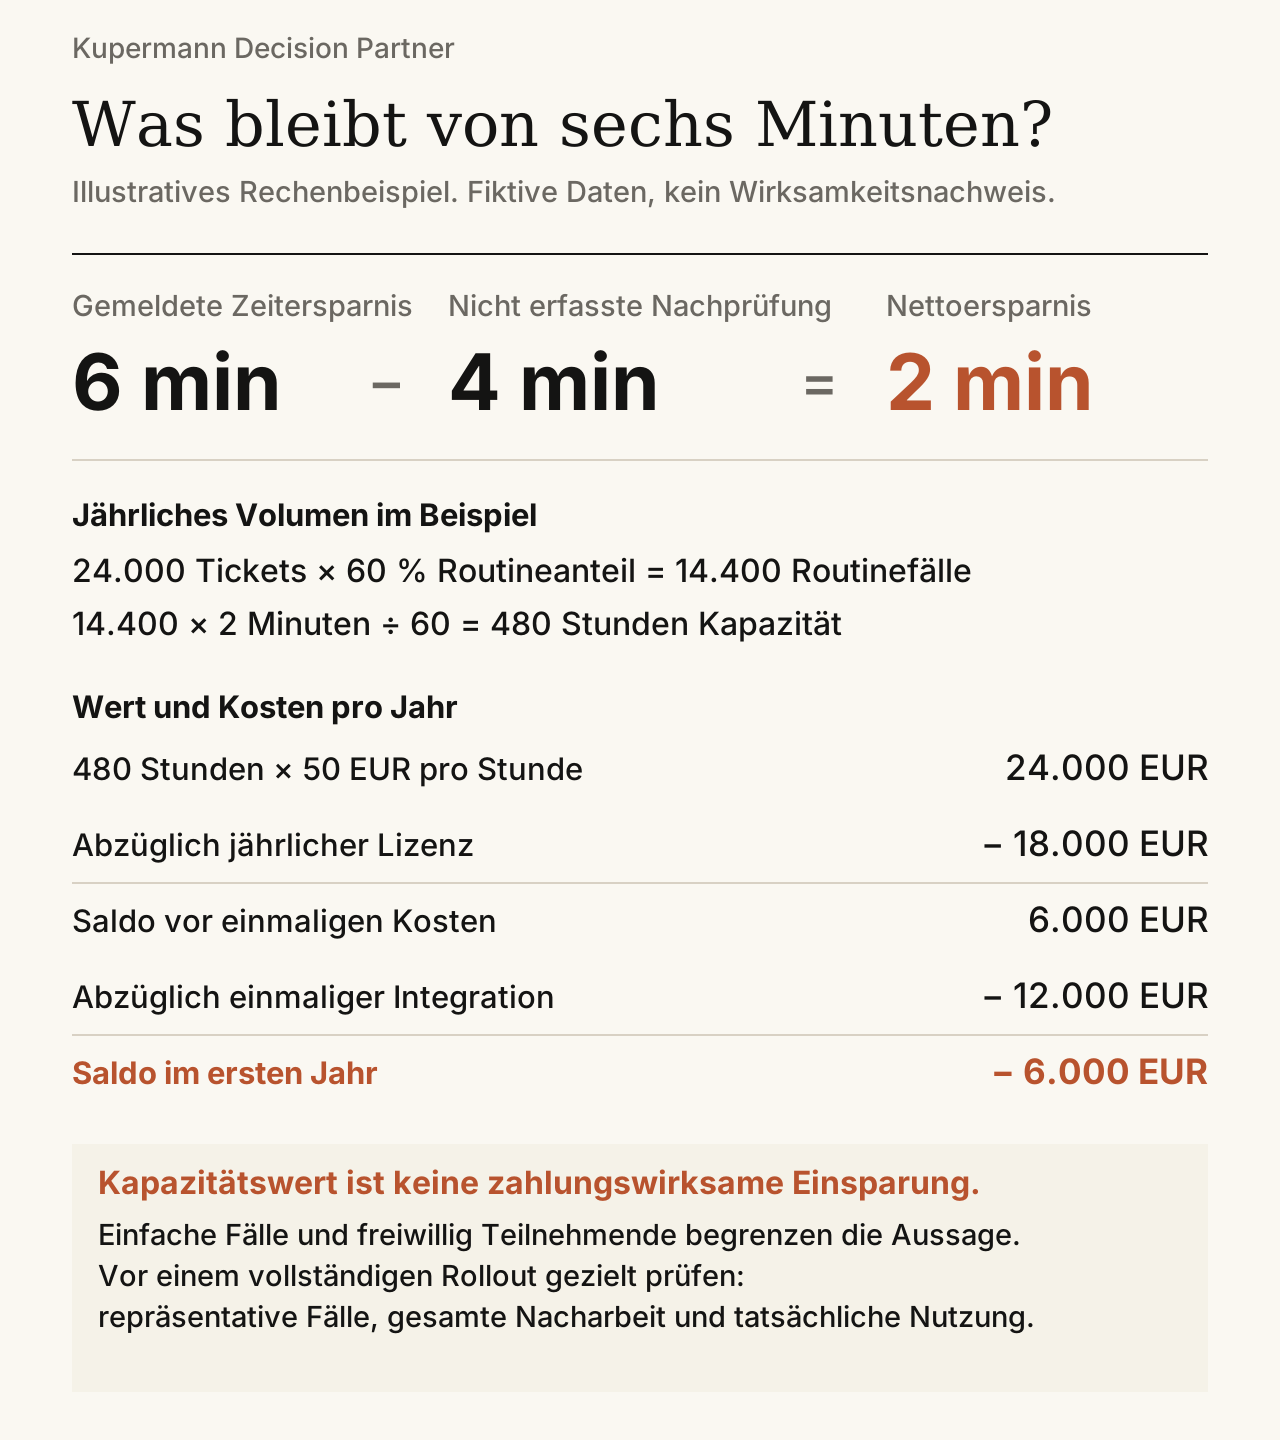
Eine Vollausrollung ist auf dieser Grundlage noch nicht begründet. Ein gezielter weiterer Test kommt dann in Betracht, wenn sein erwarteter Beitrag zur Entscheidung den Aufwand und die Kosten rechtfertigt. Er würde vollständige Bearbeitungszeiten einschließlich Nacharbeit erfassen und mit einem vergleichbaren Ablauf ohne KI vergleichen. Die Fallauswahl muss den geplanten Einsatz abbilden, und die Qualitätsprüfung sollte Fehler auch unabhängig von den Pilotanwendern suchen. Welche Fehler zum Abbruch führen und welches wirtschaftliche Ergebnis eine Einführung rechtfertigt, wird vorab festgelegt. Lässt sich die entscheidende Unsicherheit wirtschaftlich nicht klären, ist auch der Verzicht auf den nächsten Test eine sachliche Entscheidung.
Praktischer Einsatz und Grenzen
Das englischsprachige Repository stellt die Arbeitsanleitung, Vorlagen und den ausgearbeiteten Beispielfall bereit. Ein sinnvoller Einstieg ist eine konkrete, begrenzte Entscheidung mit einer benannten verantwortlichen Person. Vorhandene Informationen und Einschätzungen bilden den Ausgangspunkt für die Untersuchung. Der Abschluss hält Empfehlung, abweichende Argumente, verbleibende Unsicherheit und einen konkreten Anlass zur Neubewertung fest.
Das Verfahren verursacht Aufwand. Es verlangt Quellenprüfung, Aufmerksamkeit und die Bereitschaft, eine anfänglich attraktive Empfehlung zu verwerfen. Es schützt weder technisch vor falschen Modellantworten noch garantiert es, dass die Anleitung in jeder Unterhaltung eingehalten wird. Ob es gegenüber einem guten, weniger strukturierten Vorgehen einen zusätzlichen Nutzen bringt, muss unter vergleichbaren Bedingungen untersucht werden. Auch eine unveränderte oder schlechtere Entscheidung wäre ein relevantes Ergebnis.
Eine gute Arbeitsanleitung macht Entscheidungen prüfbarer. Verantworten muss sie weiterhin jemand.